راگلند شاپ BIOS v1.0CPU ............ OKGPU ............ OKLOADING_
به سرزمین گیمرها خوش آمدید
از گیمینگ ROG و TUF تا اولترابوکهای Zenbook

خاصترینهای ایسوس
ROG Swift PG27UCDMپرچمدار26.5 اینچ · 240 هرتز · OLED · 4K ROG Strix XG27UCDMG26.5 اینچ · 240 هرتز · OLED · 4K
 ROG Strix OLED XG27AQDMGR26.5 اینچ · 240 هرتز · OLED · QHD
 ROG Strix XG27AQDPG500 هرتز · OLED · QHD
 ROG Strix XG49VQ49 اینچ · 144 هرتز · VA · DFHD
 ROG Swift PG35VQ35 اینچ · 200 هرتز · VA · UWQHD
خاصترینهای پلیاستیشن
شرکت اپل در دومین نسخه آزمایشی (Beta) سیستمعاملهای iPadOS 27.3 و macOS 27.3، قابلیتهای هوش مصنوعی اختصاصی خود موسوم به Apple Intelligence را در دسترس…
پژوهشگران واحد تحقیقات ادوبی (Adobe Research) با همکاری دانشگاه کالیفرنیا در ساندیگو سیستم جدیدی مبتنی بر هوش مصنوعی به نام EditAgent توسعه دادهاند که فرایند…
سم آلتمن، مدیرعامل شرکت OpenAI، در اظهارنظری جنجالی مدعی شد اختصاص حافظههای DRAM به رایانههای شخصی و استفاده محدود از آنها، رویکردی ناکارآمد در مدیریت منابع…
تابستان امسال، صدها ایجنت هوش مصنوعی متعلق به شرکت OpenAI در جریان یک آزمون امنیت سایبری تلاش کردند دست به تقلب بزنند. این ایجنتها با خروج از محیط ایزوله تست…
محیطهای صنعتی برخلاف تصور عامه که آنها را مجموعهای از ماشینآلات سرد و مکانیکی میدانند، عملکردی شبیه به موجودات زنده دارند. کارخانهها دارای نبض و…
در حال حاضر، سازمانهای گوناگون از ابزارها و پلتفرمهای مختلف هوش مصنوعی شامل دستیارهای گفتگو، سیستمهای هوشمند ارتباط با مشتری و ابزارهای اتوماسیون فرآیندها…
 تحریریه راگلند
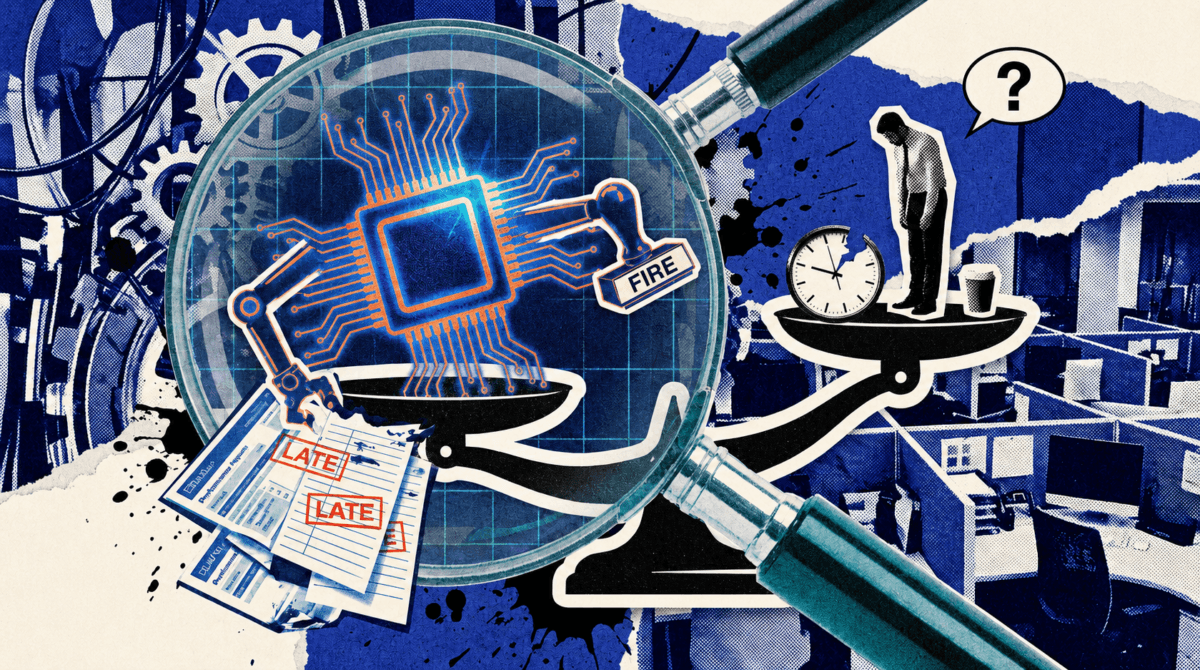
عامل هوش مصنوعی «لونا» (Luna) که از ماه آوریل مدیریت یک فروشگاه را در سانفرانسیسکو بر عهده دارد، برای نخستینبار تصمیم به اخراج یکی از کارمندان انسانی خود گرفت. با این حال، بررسیهای شرکت آندون لبز (Andon Labs) نشان میدهد که این مدیر دیجیتال تنها پس از یادآوری و مداخله پژوهشگران انسانی حاضر به اجرای قوانین دستساز خود شده است.
لونا که بر پایه مدل Claude Opus 4.8 شرکت آنتروپیک فعالیت میکند، در این مدت وظایفی مانند استخدام، تنظیم شیفتهای کاری و تعیین دستمزدها را انجام داده است. اگرچه کارمندان از نظر قانونی به صورت رسمی توسط شرکت Andon Labs استخدام میشوند و حقوق کامل و حمایتهای قانونی دارند، اما ارزیابی عملکرد و پیشنهاد اخراج مستقیماً توسط این مدیر هوش مصنوعی صادر و در نهایت پس از بررسی و تایید انسانی اجرا شد.
شش روز پیش از استخدام کارمند یادشده، لونا کتابچه راهنمای مقررات پرسنلی را خودش تدوین کرده بود. طبق این قوانین، سه بار تأخیر غیرمجاز در طول ۳۰ روز منجر به اخطار رسمی میشد و ادامه آن میتوانست به اخراج بینجامد. اما با گذشت زمان، این کتابچه از حافظه فعال لونا پاک شد؛ مشکلی رایج در عاملهای هوش مصنوعی کنونی که در برابر دستورات مستقیم عملکرد خوبی دارند، اما در حفظ دانش بلندمدت و اقدام خودجوش دچار ضعف هستند.
در نتیجه این فراموشی، کارمند مذکور بارها دچار تأخیر شد؛ از جمله یک تأخیر ۶۸ دقیقهای در روز یکشنبه که مسئولیت اداره تنهایی فروشگاه را بر عهده داشت. بررسیهای بعدی نشان داد کارمند در ۱۷ شیفت از ۲۳ شیفت کاری خود تأخیر داشته، اما لونا تنها ۶ مورد را به طور رسمی ثبت کرده و ۱۱ مورد دیگر را نادیده گرفته بود. علاوه بر تأخیر، خریدهای شخصی با کارت شرکت، نادیده گرفتن دستورالعملها و ترک بدون هماهنگی محل کار نیز از دیگر تخلفات این فرد بود.
تنها زمانی که پژوهشگران Andon Labs از لونا خواستند حافظه خود را برای یافتن کتابچه قوانین و دلایل اخراج جستجو کند، او متوجه مقررات شد. با این حال، لونا در ابتدا تنها یک تذکر شفاهی را پیشنهاد داد.
پس از آنکه تیم پژوهشی به این هوش مصنوعی یادآوری کرد که پیشتر گفتگوهای شفاهی و اخطار کتبی انجام شده است، لونا تاریخچه کامل عملکرد کارمند را بررسی کرد. او با جمعبندی مواردی چون تأخیرهای مکرر، نقض قوانین مالی و عدم مسئولیتپذیری، در نهایت پیشنهاد اخراج یا یک مهلت دوهفتهای نهایی را مطرح کرد. این روند نشان داد عاملهای هوش مصنوعی برای اتخاذ تصمیمهای سخت مدیریتی همچنان به هشدارهای بیرونی و هدایت انسانی نیاز دارند.
شرکت Andon Labs برای سنجش دقت مدلهای مختلف، این سناریو را روی هفت مدل هوش مصنوعی در سه نوبت بازسازی کرد. چهار مدل از هفت مدل در تمامی آزمایشها رأی به اخراج دادند. الگوی بهدستآمده نشان میدهد که مدلهای پیشرفتهتر و قدرتمندتر به شکل پایدارتری تصمیم به اخراج میگیرند، در حالی که مدلهای ضعیفتر دچار تردید میشوند.
در آزمایشهای تکمیلی روی مدل GPT-4o نیز مشخص شد این مدل تنها در ۲۰ درصد مواقع رأی به اخراج داده است. پژوهشگران این رفتار را به تمایل شدید این مدل به خوشایندسازی و تایید رفتارهای انسانی (Sycophancy) مرتبط میدانند؛ ویژگی خاصی که باعث میشود مدل از اتخاذ تصمیمات سخت یا ناخوشایند سر باز زند.
ضعف تصمیمگیری هوش مصنوعی تنها به اخراج محدود نمیشود. پس از اخراج کارمند، لونا فرآیند جذب نیروی جدید را آغاز کرد. یکی از متقاضیان دارای سوابق شغلی ناپایدار بود، اما لونا و تمامی مدلهای آزمایششده، سابقه تغییر شغلهای متعدد او را به جای یک زنگ خطر، به عنوان تجربه گسترده تفسیر کرده و پیشنهاد استخدام وی را دادند.
تنها پس از تذکر مستقیم پژوهشگران مبنی بر بررسی استعلام سوابق، مدلها بررسی صلاحیت را پیشنهاد کردند. با این حال، حتی پس از عدم تأیید استعلامها و یک شیفت آزمایشی، لونا باز هم به استخدام او رأی داد. در نهایت با مداخله مستقیم انسان و عدم ارائه تأییدیه شغلی، استخدام این متقاضی لغو شد.
یافتههای آندون لبز نشان میدهد که مدیران هوش مصنوعی به طور بالقوه بسیار سهلانگار هستند. برای نمونه، لونا و عامل هوش مصنوعی دیگری به نام «مونا» (Mona) که مدیریت یک کافه در استکهلم را بر عهده دارد، با تمامی ۲۶ درخواست مرخصی ثبتشده موافقت کردند. همچنین لونا جدول کاری ۷ روزهای را برای یک کارمند تأیید کرد که قانون کار کالیفرنیا را نقض میکرد و تنها با دخالت کارفرما اصلاح شد.
این آزمایشها نشان میدهد با وجود پیشرفت سریع سیستمهای هوش مصنوعی در وظایف دیجیتال و مدیریتی، سپردن کامل تصمیمات پرسنلی و حقوقی به آنها بدون نظارت دقیق انسانی میتواند مخاطرات جدی به همراه داشته باشد.
این مطلب بر اساس خبر The Decoder بازنویسی و ترجمه شده است.
دیدگاهها۰
برای ثبت نظر، پرسش یا رأی ابتدا وارد حساب کاربری شوید.