راگلند شاپ BIOS v1.0CPU ............ OKGPU ............ OKLOADING_
به سرزمین گیمرها خوش آمدید
از گیمینگ ROG و TUF تا اولترابوکهای Zenbook

خاصترینهای ایسوس
ROG Swift PG27UCDMپرچمدار26.5 اینچ · 240 هرتز · OLED · 4K ROG Strix XG27UCDMG26.5 اینچ · 240 هرتز · OLED · 4K
 ROG Strix OLED XG27AQDMGR26.5 اینچ · 240 هرتز · OLED · QHD
 ROG Strix XG27AQDPG500 هرتز · OLED · QHD
 ROG Strix XG49VQ49 اینچ · 144 هرتز · VA · DFHD
 ROG Swift PG35VQ35 اینچ · 200 هرتز · VA · UWQHD
خاصترینهای پلیاستیشن
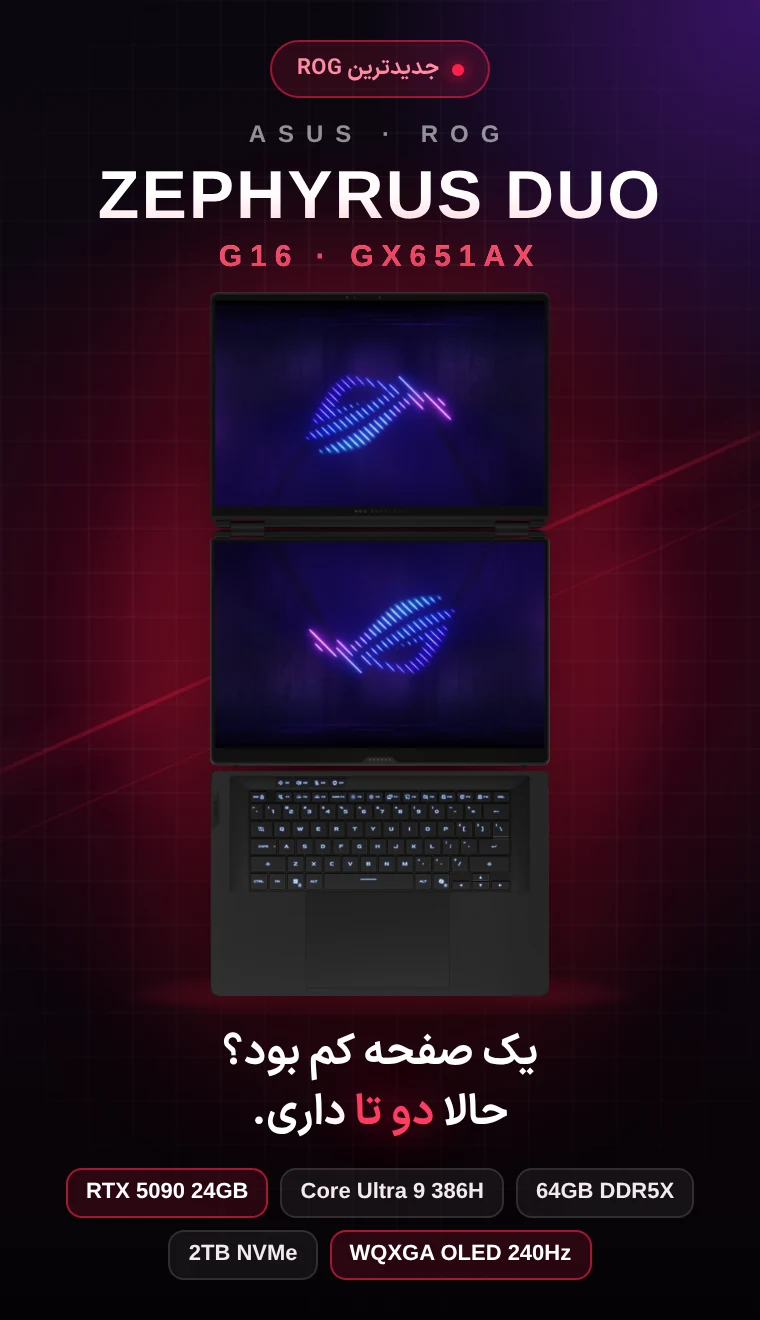
شرکت ایسوس با معرفی نسخه ۲۰۲۶ لپتاپ پرچمدار ROG Zephyrus G16، بار دیگر استانداردهای لپتاپ های گیمینگ باریک و سبک را ارتقا داده است. این محصول با بهرهگیری…
معرفی موتور گرافیکی IW 9.0 و ارتقای جلوههای بصری بازی Call of Duty: Modern Warfare 4 با یک سکانس افتتاحیه طوفانی و پربرخورد، بازیکن را مستقیماً وارد صحنه…
مواجهه کاربران با چالشهای گارانتی قطعات سختافزاری همواره یکی از موضوعات بحثبرانگیز در دنیای سختافزار بوده است. اخیراً گزارش جدیدی درباره رد درخواست گارانتی…
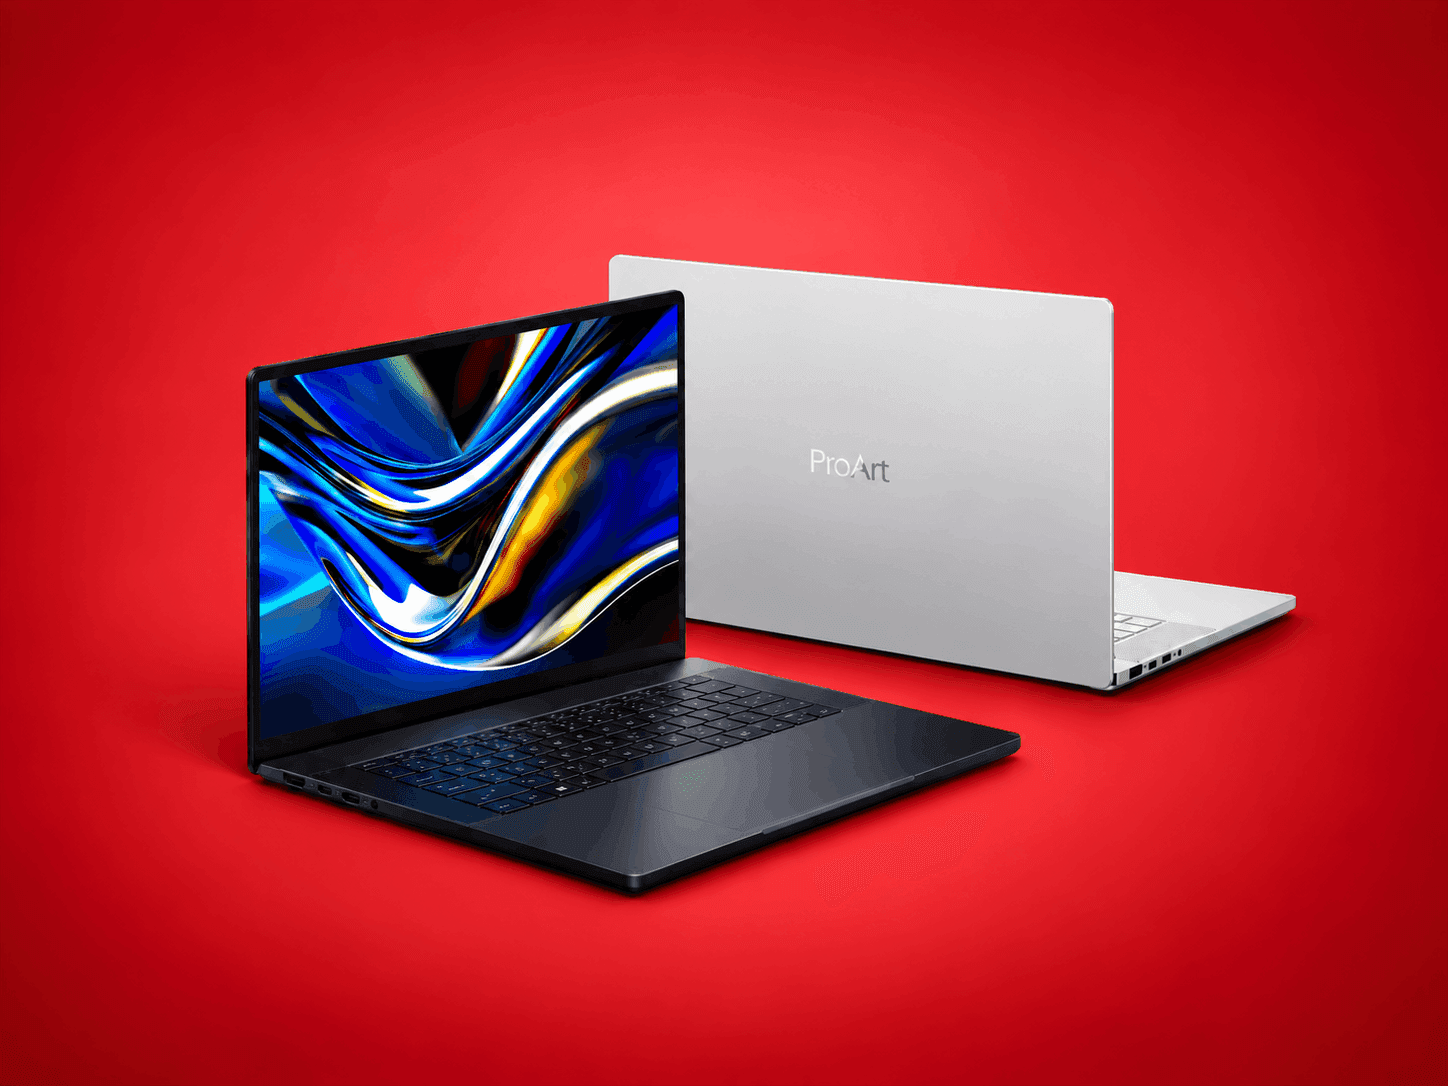
معرفی ایسوس ProArt P16؛ غول پردازشی برای هوش مصنوعی و تولید محتوا شرکت ایسوس پس از رونمایی اولیه از لپتاپ ProArt P16 (H7607) در نمایشگاه Computex، رسماً تاریخ…
کمپانی لنوو از جدیدترین لپتاپ باریک و سبک خود با نام Xiaoxin 14 SE در بازار چین رونمایی کرد. این اولترابوک اداری و مدیریتی که گزینهای ایدهآل برای کارهای…
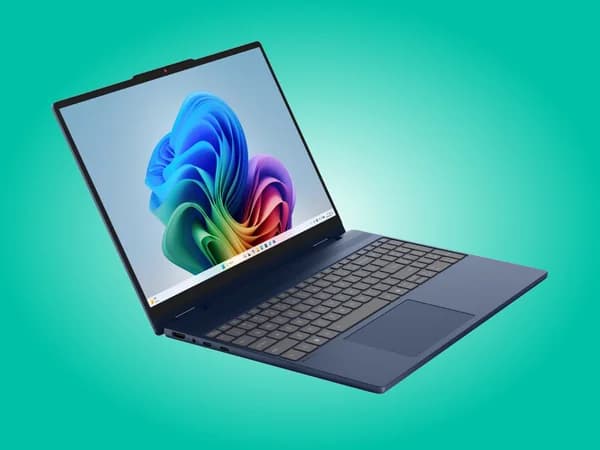
کمپانی لنوو از جدیدترین لپتاپ هیبریدی خود با نام IdeaPad 5 2-in-1 15IWC11 رونمایی کرد. این اولترابوک ۱۵ اینچی با تمرکز بر شارژدهی فوقالعاده باتری، طراحی…
 تحریریه راگلند
در جریان کنفرانس Hot Chips 2026، ایگور آرسوفسکی (Igor Arsovski)، معماری ارشد سابق شرکت Groq و معاون فعلی بخش سختافزار انویدیا، رسماً از رکهای جدید Groq 3 LPX رونمایی کرد. این سختافزار مبتنی بر تراشههای LP30 طراحی شده است؛ محصولی که انویدیا در دسامبر ۲۰۲۵ طی قراردادی ۲۰ میلیارد دلاری حقوق مالکیت فکری و تیم مهندسی آن را تصاحب کرد و آن را جایگزین شتابدهنده Rubin CPX در نقشه راه خود ساخت. به گفته انویدیا، تولید انبوه رکهای این پردازنده آغاز شده است.
بر اساس نخستین بنچمارکهای مستقل منتشرشده توسط مؤسسه Artificial Analysis، این سختافزار روی مدل استدلال Gemma 4 31B با طول کانتکست ۱۰۰ هزار توکن به نرخ خروجی ۳,۴۳۱ توکن در ثانیه دست یافته است. این میزان تقریباً ۴ برابر سریعتر از نزدیکترین رقیب با سرعت ۸۷۰ توکن در ثانیه است. انویدیا همچنین در دموی اختصاصی خود به سرعت ۱۰,۹۹۶ توکن در ثانیه دست یافت که به گفته آرسوفسکی جهت ارزیابی دقیقتر باید در شرایط اجرایی مختلف بررسی شود.
هر تراشه LP30 دارای حدود ۵۰۰ مگابایت حافظه SRAM روی دای (On-Die) است و هیچگونه حافظه HBM در آن استفاده نشده است. بر این اساس، یک رک کامل LPX شامل ۲۵۶ تراشه، در مجموع از ۱۲۸ گیگابایت حافظه بهره میبرد که پهنای باند کلی ۴۰ پتابایت بر ثانیه (PB/s) را در کنار توان محاسباتی ۳۱۵ پتافلاپس در دقت FP8 ارائه میدهد. تاخیر تراشه به تراشه در این رکهای مجهز به خنککننده مایع MGX و سازگار با پلتفرم Vera Rubin، تنها ۳۵۰ نانومتر است.
حذف حافظه HBM و نگه داشتن وزنهای مدل به طور کامل درون حافظه SRAM باعث میشود تاخیر فراخوانی حافظه در فاز رمزگشایی (Decode) تک توکنها به حداقل برسد. خط لوله پردازشی این معماری با حذف کش، پیشبینی پرش و اجرای غیرترتیبی، کاملاً قطعی (Deterministic) عمل کرده و زمانبندی دستورات را در سطح سیکلهای ساعت توسط کامپایلر مدیریت میکند.
انویدیا رکهای LPX را به عنوان پردازندههای کمکی فاز رمزگشایی در کنار سیستمهای Vera Rubin NVL72 معرفی میکند. در این ساختار، پردازندههای گرافیکی Rubin فاز سنگین محاسباتی Prefill و ساخت حافظه کش KV را انجام میدهند، در حالی که واحد پردازش پردازش زبانی (LPU) مسئولیت تولید توکنهای خروجی را بر عهده میگیرد.
ارتباط میان محیط همگام LPU و سیستمهای ناهمگام ورودی/خروجی میزبان از طریق یک مدار مجتمع FPGA برقرار میشود. به همراه زمانبندی جدید Dynamo و توسعههای LPU در پلتفرم CUDA، این معماری ترکیبی عملکرد استنتاج مدلهای ۲ تریلیون پارامتری را تا ۳ تا ۵ برابر نسبت به اجرای تنها روی پردازندههای Rubin بهبود میبخشد.
همزمان با انویدیا، شرکت Cerebras نیز از سیستم Wafer-Scale جدید خود به نام CS4 رونمایی کرد. این سیستم از پلتفرم ماژولار Nexus استفاده میکند و پهنای باند حافظه آن به ۴۳ پتابایت بر ثانیه میرسد. Cerebras اعلام کرده است که سیستم CS4 تا ۳۰ برابر سریعتر از GPUهای مرسوم عمل میکند و با همکاری شرکت AMD، از پردازندههای گرافیکی سری AMD Helios برای فاز Prefill استفاده خواهد کرد؛ راهکاری مشابه با الگوی ادغامشده انویدیا و Groq که رقابت در حوزه شتابدهندههای استنتاج هوش مصنوعی را وارد مرحله تازهای کرده است.
این مطلب بر اساس خبر Tom’s Hardware بازنویسی و ترجمه شده است.
دیدگاهها۰
برای ثبت نظر، پرسش یا رأی ابتدا وارد حساب کاربری شوید.