

راهاندازی OpenClaw: اجرای هوش مصنوعی محلی روی سختافزار معمولی
 تحریریه راگلند
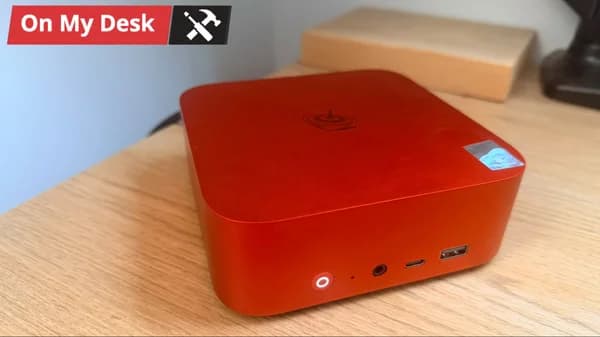
OpenClaw، ابزاری که توسط پیتر اشتاینبرگر توسعه یافته، از اوایل سال ۲۰۲۶ بهسرعت در صدر اخبار قرار گرفته است. این موتور میتواند یک عامل هوش مصنوعی ایجاد کند که بهطور خودکار از طرف شما عمل کرده و قابلیتهایی نظیر اجرای فایلها، مرور وب و بسیاری موارد دیگر را دارد. با استفاده از سیستمی به نام «Skills»، میتوانید به دستیار هوش مصنوعی خود وظایف جدیدی را آموزش دهید، و ادغامهای جدید روزانه در حال ظهور هستند. اما این ابزار برای یک کاربر عادی چقدر مفید است؟ برای پاسخ به این پرسش، من از یک مینی کامپیوتر نسبتاً معمولی Beelink SER10 MAX استفاده کردم که OpenClaw بهصورت پیشفرض روی آن نصب شده بود.
در ابتدا، هنگام نصب OpenClaw، باید تصمیم مهمی بگیرید: آیا میخواهید به منابع ابری و مدلهای هوش مصنوعی قدرتمندتر متکی باشید یا میخواهید آن را بهصورت محلی اجرا کنید؟ Beelink SER10 MAX با مدل Qwen-3.5 9B عرضه میشود که یک مدل هوش مصنوعی نسبتاً قدیمی و منسوخ است. از آنجایی که قصد داشتم کارها را ساده نگه دارم، ابتدا مسیر هوش مصنوعی محلی را انتخاب کردم. برای اجرای مدلهای بزرگتر، به حافظه زیادی نیاز دارید، بنابراین ابتدا حافظه ویدیویی این مینی کامپیوتر را به ۴۸ گیگابایت افزایش دادم که به ما اجازه میدهد یک مدل بزرگتر و پیچیدهتر را در حافظه نگه داریم. این کار همچنین ۱۶ گیگابایت حافظه سیستم را برای ما باقی میگذارد که بیش از حد کافی برای اجرای ترمینال و اطمینان از عملکرد صحیح همه چیز است.
انتخاب مدل هوش مصنوعی محلی ایدهآل
وجود ۴۸ گیگابایت حافظه ویدیویی در دسترس به ما امکان میدهد یک مدل هوش مصنوعی نسبتاً قدرتمند را روی سیستم اجرا کنیم. با این حال، نقطه ضعف اجرای یک مدل بزرگتر این است که سرعت توکن (token speed) احتمالاً کمی کمتر از حد انتظار خواهد بود. اما برای اجرای هوش مصنوعی فوقهوشمندی که کارها را بهصورت محلی برای ما انجام میدهد، به بیشترین هوش ممکن نیاز داریم. برای این آزمایش، من Google Gemma 4 31B (UD-Q8_K_XL) را انتخاب کردم که یک کوانتیزاسیون تقریباً بدون اتلاف است و همانطور که بهزودی متوجه شدم، انتخابی نسبتاً جاهطلبانه بود.
پس از دانلود مدل و اجرای آن در llama.cpp، به سرعت ۲.۳۴ توکن بر ثانیه دست یافتیم. بهطور متوسط، درخواستهای روزمره ۱۱۶ توکن برای تولید نیاز داشتند که با سرعت ۲.۳۴ توکن بر ثانیه، برای استفاده روزمره و سریع، هنوز بسیار کند بود. بنابراین، نفس عمیقی کشیدم و اعتراف کردم که Ryzen AI 9 HX 470 حافظه و پهنای باند حافظه کافی برای اجرای چنین مدل بزرگی را با سرعت توکن قابل قبول ندارد. حتی اگر کوانتیزاسیون را به ۴-بیت کاهش میدادم، همچنان حداکثر نظری حدود ۵ توکن بر ثانیه را برای این مدل خاص انتظار داشتیم. اگر یک سیستم سریعتر با سرعت RAM بالا، مانند یک سیستم Strix Halo (مانند Framework Desktop) داشتید، ممکن بود کارآمدتر باشد، اما برای یک قطعه سیلیکون با مشخصات پایینتر و سرعتهای نسبتاً معمولی DDR5-5600، باید یک مدل کمی سادهتر را بپذیرید.
در نهایت، به این نتیجه رسیدم که Gemma 12B (Q4_K_M) کوچکتر، انتخاب بسیار منطقیتری برای دستگاهی با این کالیبر است. پس از بارگذاری آن در llama.cpp، توانستیم به سرعت بسیار معقولتر ۱۰.۶۴ توکن بر ثانیه در یک پرسش دانش عمومی (مثلاً: “Tom’s Hardware چیست؟”) دست یابیم. حالا که یک تکه شن برقی سخنگو روی میز کارم دارم، وقت آن است که OpenClaw را پیکربندی کنم.
دیدگاهها۰
برای ثبت نظر، پرسش یا رأی ابتدا وارد حساب کاربری شوید.