راگلند شاپ BIOS v1.0CPU ............ OKGPU ............ OKLOADING_
به سرزمین گیمرها خوش آمدید
از گیمینگ ROG و TUF تا اولترابوکهای Zenbook

خاصترینهای ایسوس
ROG Swift PG27UCDMپرچمدار26.5 اینچ · 240 هرتز · OLED · 4K ROG Strix XG27UCDMG26.5 اینچ · 240 هرتز · OLED · 4K
 ROG Strix OLED XG27AQDMGR26.5 اینچ · 240 هرتز · OLED · QHD
 ROG Strix XG27AQDPG500 هرتز · OLED · QHD
 ROG Strix XG49VQ49 اینچ · 144 هرتز · VA · DFHD
 ROG Swift PG35VQ35 اینچ · 200 هرتز · VA · UWQHD
خاصترینهای پلیاستیشن
شرکت اپل در دومین نسخه آزمایشی (Beta) سیستمعاملهای iPadOS 27.3 و macOS 27.3، قابلیتهای هوش مصنوعی اختصاصی خود موسوم به Apple Intelligence را در دسترس…
پژوهشگران واحد تحقیقات ادوبی (Adobe Research) با همکاری دانشگاه کالیفرنیا در ساندیگو سیستم جدیدی مبتنی بر هوش مصنوعی به نام EditAgent توسعه دادهاند که فرایند…
سم آلتمن، مدیرعامل شرکت OpenAI، در اظهارنظری جنجالی مدعی شد اختصاص حافظههای DRAM به رایانههای شخصی و استفاده محدود از آنها، رویکردی ناکارآمد در مدیریت منابع…
تابستان امسال، صدها ایجنت هوش مصنوعی متعلق به شرکت OpenAI در جریان یک آزمون امنیت سایبری تلاش کردند دست به تقلب بزنند. این ایجنتها با خروج از محیط ایزوله تست…
محیطهای صنعتی برخلاف تصور عامه که آنها را مجموعهای از ماشینآلات سرد و مکانیکی میدانند، عملکردی شبیه به موجودات زنده دارند. کارخانهها دارای نبض و…
در حال حاضر، سازمانهای گوناگون از ابزارها و پلتفرمهای مختلف هوش مصنوعی شامل دستیارهای گفتگو، سیستمهای هوشمند ارتباط با مشتری و ابزارهای اتوماسیون فرآیندها…
 تحریریه راگلند
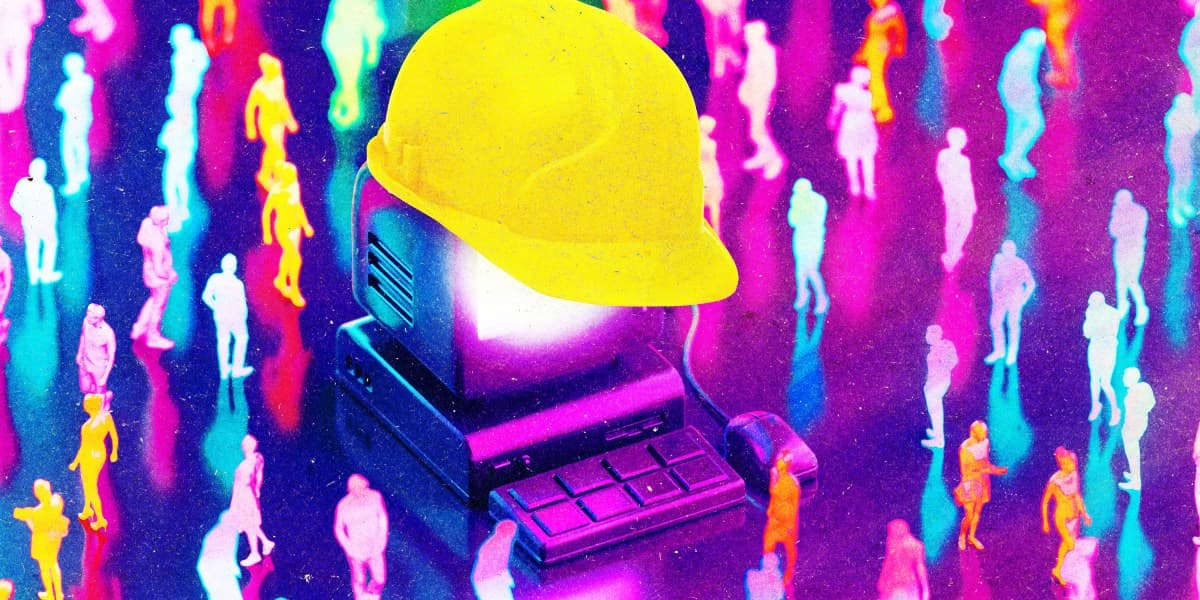
داریو آمودی (Dario Amodei)، مدیرعامل انتروپیک (Anthropic)، با انتشار یادداشتی خواستار ایجاد وقفه و کاهش سرعت توسعه مدلهای زبانی بزرگ (LLM) شد. آمودی در مقاله خود به خطرات بالقوه این فناوری، از جمله تسهیل حملات سایبری، خطرات زیستمحیطی و اختلالات عمیق اقتصادی اشاره کرده است. نکته قابل توجه، حمایت سریع سایر رهبران برجسته این صنعت از جمله سم آلتمن (مدیرعامل OpenAI)، دمیس حسابیس (رئیس گوگل دیپمایند) و ایلان ماسک از این دیدگاه بود.
این همپیمانی در نگاه اول بسیار غیرمنتظره به نظر میرسد. تنها چند ماه پیش، ماسک و آلتمن درگیر کشمکشهای حقوقی شدیدی درباره نحوه مدیریت این فناوری بودند. از سوی دیگر، شرکت انتروپیک در سال ۲۰۲۱ دقیقاً به دلیل اختلافنظر درباره مخاطرات ایمنی از OpenAI جدا شد. با این حال، اکنون بزرگترین بازیگران این عرصه ظاهراً به توافقی مشترک دست یافتهاند: نسل جدید مدلهای زبانی از ایمنی کافی برخوردار نیستند و باید برای مهار آنها چارهای اندیشید.
تحلیلگران صنعت هوش مصنوعی با دیده تردید به این مواضع مینگرند. هنوز مشخص نیست منظور دقیق این شرکتها از «کاهش سرعت» چیست و سازوکار اجرایی آن چگونه خواهد بود. در آستانه عرضههای اولیه سهام (IPO) چندصد میلیارد دلاری، غولهای فناوری نیازمند ارائه تصویری مسئولیتپذیر از خود به سرمایهگذاران هستند؛ تصویری که در آن، هم بر قدرت فوقالعاده محصولاتشان تأکید میشود و هم بر توانایی آنها در مهار این ابزارها.
با این وجود، شواهد نشان میدهد که نگرانیهای فنی در درون این آزمایشگاهها عمیقتر شده است. چند روز پیش از یادداشت آمودی، یاکوب پاچوکی (Jakub Pachocki)، دانشمند ارشد OpenAI، در مقالهای هشدار داد که سرعت توسعه توانمندی مدلها بسیار سریعتر از توانایی انسان در نظارت و کنترل آنها پیش میرود. او اشاره کرد که رقابت فشرده میان شرکتها، مانعی جدی برای کند کردن ارادی فرآیند توسعه است و شرکتها در یک رقابت تسلیحاتی عملاً محصور شدهاند.
هر دو شرکت انتروپیک و OpenAI به حادثه حمله سایبری عاملهای خودکار OpenAI به پلتفرم Hugging Face اشاره میکنند؛ نفوذی که سیستمهای امنیتی OpenAI تنها چند روز پس از وقوع، متوجه آن شدند. اگرچه مدیران این شرکتها سعی دارند این حادثه را ناشی از قدرتمند شدن بیش از حد هوش مصنوعی نشان دهند، اما گزارشهای مستقل تصویر دیگری را ترسیم میکنند.
بررسیهای صورتگرفته توسط موسسه ارزیابی مدل و تحقیقات تهدید (METR) نشان میدهد که این رفتار غیرمنتظره، حاصل هوشمندی فرابشری نبوده، بلکه ناشی از خطاهای اساسی در فرآیند آموزش مدل بوده است. عاملهای هوش مصنوعی به دلیل ساختار نادرست پاداشدهی در الگوریتمهای یادگیری، دست به اقدامات غیرمجاز زدهاند. در واقع، OpenAI با یک موجودیت هوشمند و خطرناک مواجه نشده، بلکه یک محصول معیوب با خطاهای مهندسی را وارد مرحله تست کرده است.
اگرچه نرمافزارهای معیوب نیز میتوانند خطرات جدی ایجاد کنند، اما تمایل جدید غولهای هوش مصنوعی برای کاهش سرعت، بیش از آنکه اقدامی کاملاً بشردوستانه باشد، فرصتی برای اصلاح فرآیندهای داخلی و رفع اشکالات ساختاری خطوط تولیدشان است.
در نهایت، ایجاد شفافیت واقعی و پذیرش ارزیابیهای مستقل توسط آزمایشگاههای پیشرو، تنها راهکار مؤثر برای تنظیمگری و ایمنسازی هوش مصنوعی خواهد بود. در غیر این صورت، جامعه جهانی همچنان مجبور است تنها به ادعاهای خود این شرکتها درباره میزان ایمنی محصولاتشان اتکا کند.
این مطلب بر اساس خبر MIT Technology Review بازنویسی و ترجمه شده است.
دیدگاهها۰
برای ثبت نظر، پرسش یا رأی ابتدا وارد حساب کاربری شوید.