راگلند شاپ BIOS v1.0CPU ............ OKGPU ............ OKLOADING_
به سرزمین گیمرها خوش آمدید
از گیمینگ ROG و TUF تا اولترابوکهای Zenbook

خاصترینهای ایسوس
ROG Swift PG27UCDMپرچمدار26.5 اینچ · 240 هرتز · OLED · 4K ROG Strix XG27UCDMG26.5 اینچ · 240 هرتز · OLED · 4K
 ROG Strix OLED XG27AQDMGR26.5 اینچ · 240 هرتز · OLED · QHD
 ROG Strix XG27AQDPG500 هرتز · OLED · QHD
 ROG Strix XG49VQ49 اینچ · 144 هرتز · VA · DFHD
 ROG Swift PG35VQ35 اینچ · 200 هرتز · VA · UWQHD
خاصترینهای پلیاستیشن
شرکت اپل در دومین نسخه آزمایشی (Beta) سیستمعاملهای iPadOS 27.3 و macOS 27.3، قابلیتهای هوش مصنوعی اختصاصی خود موسوم به Apple Intelligence را در دسترس…
پژوهشگران واحد تحقیقات ادوبی (Adobe Research) با همکاری دانشگاه کالیفرنیا در ساندیگو سیستم جدیدی مبتنی بر هوش مصنوعی به نام EditAgent توسعه دادهاند که فرایند…
سم آلتمن، مدیرعامل شرکت OpenAI، در اظهارنظری جنجالی مدعی شد اختصاص حافظههای DRAM به رایانههای شخصی و استفاده محدود از آنها، رویکردی ناکارآمد در مدیریت منابع…
تابستان امسال، صدها ایجنت هوش مصنوعی متعلق به شرکت OpenAI در جریان یک آزمون امنیت سایبری تلاش کردند دست به تقلب بزنند. این ایجنتها با خروج از محیط ایزوله تست…
محیطهای صنعتی برخلاف تصور عامه که آنها را مجموعهای از ماشینآلات سرد و مکانیکی میدانند، عملکردی شبیه به موجودات زنده دارند. کارخانهها دارای نبض و…
در حال حاضر، سازمانهای گوناگون از ابزارها و پلتفرمهای مختلف هوش مصنوعی شامل دستیارهای گفتگو، سیستمهای هوشمند ارتباط با مشتری و ابزارهای اتوماسیون فرآیندها…
 تحریریه راگلند
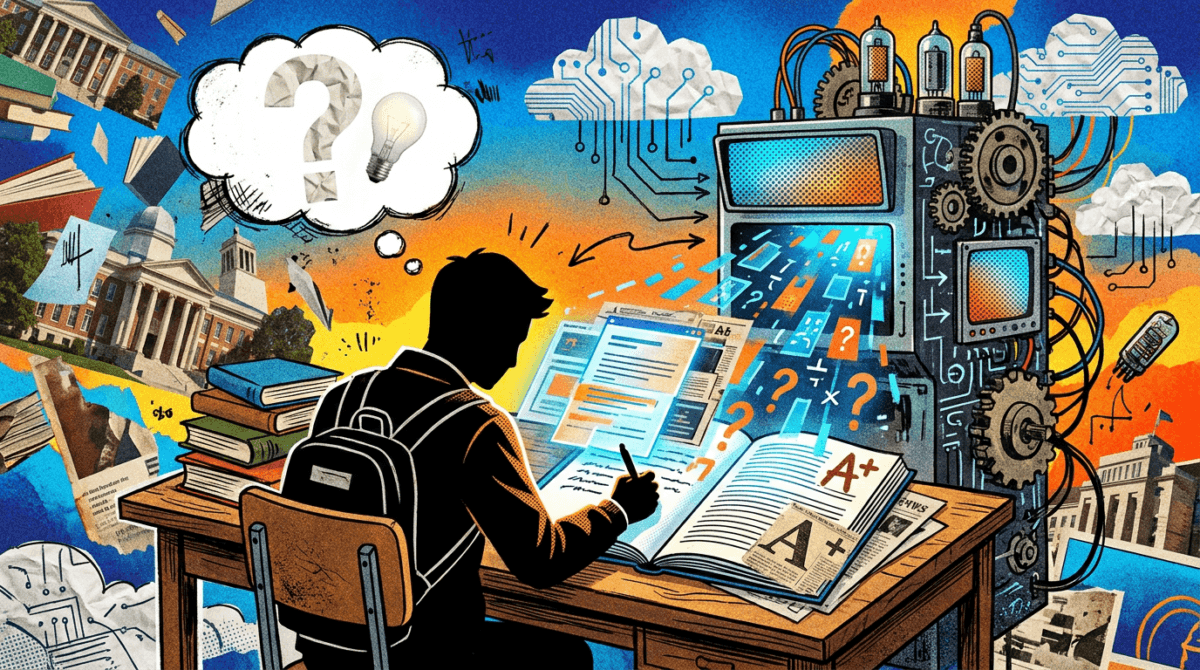
پژوهشهای جدید نشان میدهد که ابزارهای هوش مصنوعی مانند چتجیپیتی میتوانند نمرات دانشگاهی دانشجویان را به میزان چشمگیری ارتقا دهند. با این حال، مسئله اصلی همچنان باقی است: آیا این ابزارها به یادگیری واقعی کمک میکنند یا تنها ظاهر خروجی کار را بهبود میبخشند؟ آزمایشهای میدانی جدید در دانشگاه بوکونی (Bocconi) ابعاد تازهای از این چالش را آشکار ساخته است.
در پژوهشی که روی ۱,۰۵۳ دانشجوی سال اول مدیریت در قالب ۱۳ گروه انجام شد، شرکتکنندگان به چهار دسته تقسیم شدند: گروه کنترل، گروه دریافتکننده آموزش «استدلال علّی» (Causal Reasoning)، گروه دارای دسترسی به مدل GPT-4o و گروهی که از هر دو بهرهمند بودند. وظیفه دانشجویان ارائهی توصیههای بازاریابی کوتاه برای فروشگاه دانشگاه بود.
نتایج نشان داد دانشجویانی که به GPT-4o دسترسی داشتند، در یک مقیاس ۱ تا ۵، به طور میانگین نزدیک به یک امتیاز کامل نمره بالاتری کسب کردند. متون تولیدشده توسط این گروه منطقیتر، منسجمتر و به پیشنهادهای کارشناسان خبره نزدیکتر بود. با این حال، تحلیلگران تاکید میکنند که این افزایش نمره ناشی از کیفیت بالای محتوای تولیدشده توسط هوش مصنوعی بوده است، نه لزوماً افزایش دانش خود دانشجو.
نکته جالب این پژوهش به آموزش «استدلال علّی» مربوط میشد. دانشجویانی که این آموزش کوتاه را گذرانده بودند، در معیارهای نمرهدهی سنتی نمره بالاتری نگرفتند و حتی کمی ضعیفتر عمل کردند. اما پاسخهای آنها عمیقتر بود؛ آنها به طور شفافتری توضیح میدادند که چرا یک راهکار کارساز است، چه زمانی ممکن است شکست بخورد و ایدههای متنوعتری نسبت به همتایان خود ارائه میدادند.
معیارهای ارزشیابی معمول در سیستمهای آموزشی، بیشتر ساختار آراسته، انسجام ظاهری و پاسخهای متعارف را تشویق میکنند. در مقابل، ارائه ایدههای ساختارشکنانه یا ارزیابی دقیق ابطالپذیری راهکارها، در چارچوبهای نمرهدهی فعلی اغلب امتیاز کمتری دریافت میکنند. این مسئله نشان میدهد که سیستمهای نمرهدهی فعلی بیشتر «ظاهر متون» را میسنجند تا میزان «فهم و تفکر عمیق» را.
یکی از محدودیتهای اصلی این آزمایش، عدم سنجش میزان یادگیری پایدار دانشجویان است. پژوهشگران هیچ آزمون تعقیبی (Follow-up) بدون دسترسی به چتجیپیتی برگزار نکردند تا مشخص شود آیا دانشجو پس از کنار رفتن ابزار نیز مفاهیم را درک کرده است یا خیر. علاوه بر این، در این پژوهش برخی متغیرها توسط خود مدلهای هوش مصنوعی ارزشیابی شدهاند و حضور پژوهشگرانی از شرکت OpenAI نیز شفافیت مستقل پژوهش را تحت تأثیر قرار میدهد.
نگاهی به دیگر تحقیقات جدی در این حوزه، تصویر روشنتری ارائه میدهد. پژوهش روی بیش از نیم میلیون نمره دانشگاهی در ایالات متحده نشان داد پس از همهگیری چتجیپیتی، بیشترین رشد نمرات عالی در دورههای مبتنی بر کدنویسی و نوشتار رخ داده است؛ اما در آزمونهای حضوری و بدون ابزار، عملکرد دانشجویانی که اتکای مستقیمی به دریافت پاسخهای آماده از هوش مصنوعی داشتند، افت فاحشی پیدا کرد.
همچنین یک مطالعه ۳۰ ماهه روی ۲۶ هزار دانشجو در چین الگوی مشابهی را فاش کرد: تکالیف خانگی با کمک هوش مصنوعی سریعتر و بهتر انجام میشدند، اما نمرات امتحانات نهایی ۱۸ تا ۲۴ درصد کاهش یافت. تنها دانشجویانی که وقت کافی برای تحلیل شخصبهشخص تکالیف میگذاشتند و از هوش مصنوعی صرفاً به عنوان مکملی برای تفکر استفاده میکردند، دچار افت تحصیلی نشدند.
اگر هوش مصنوعی میتواند به راحتی کارهای ظاهرآراسته و شبهکارشناسی تولید کند، اتکا به خروجی نهایی متن دیگر معیار معتبری برای سنجش درک دانشجو نیست. کارشناسان معتقدند که سیستم ارزشیابی باید از بازتولید پاسخهای متعارف فاصله گرفته و به معیارهایی چون اصالت فکری، تفکر انتقادی و تحلیل گزینههای متعدد پاداش دهد؛ تغییر بزرگی که مستلزم بازنگری در کل ساختار آموزشی است.
این مطلب بر اساس خبر The Decoder بازنویسی و ترجمه شده است.
دیدگاهها۰
برای ثبت نظر، پرسش یا رأی ابتدا وارد حساب کاربری شوید.